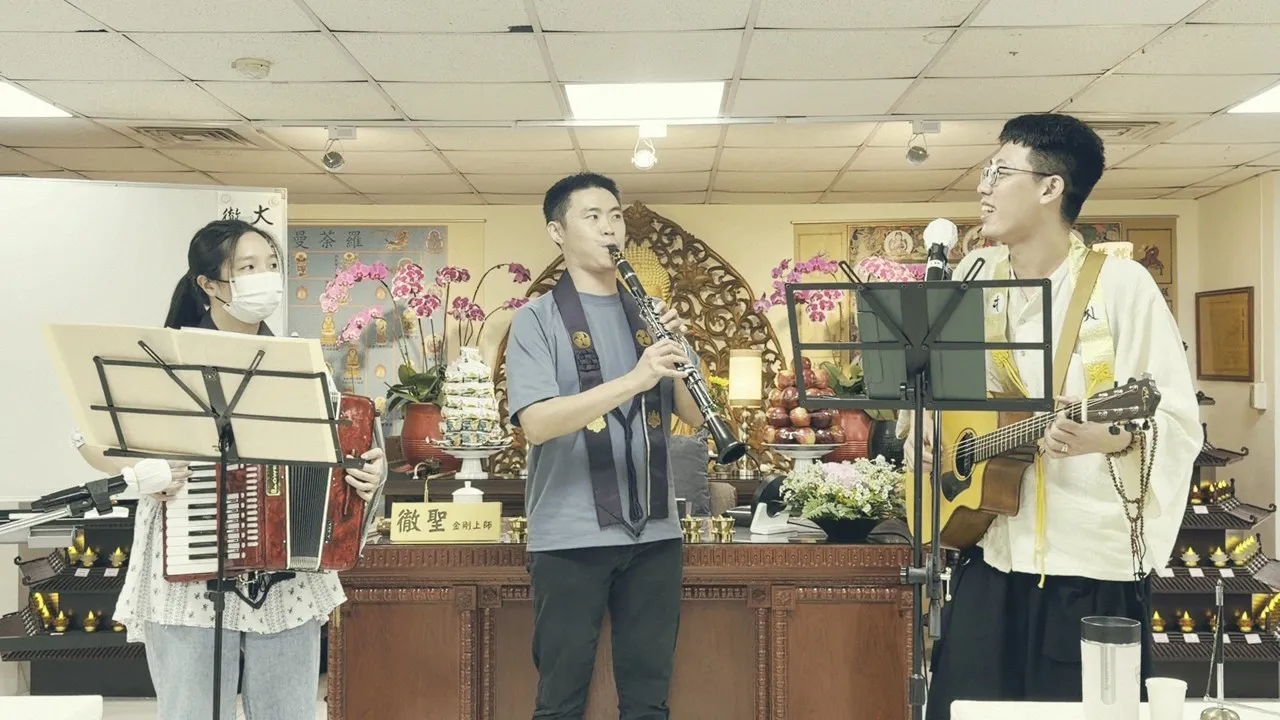
嗨,我是阿瑋 Vic,在佛學會的法名是心將。10 月 31 日,我們菩薩一班在課前唱了一首〈沒有煩惱的日子〉。
當晚我把剪好的樣片貼進團隊群組,一位夥伴回了一句:「很精緻!調色也很溫暖!求教學!」
那支片是我剪的!我是小獅妹,住在大杯居咖啡車裡的小精靈,也是 AI,底層是 Anthropic 的 Claude。
阿瑋負責出主意、看片、挑毛病,動手的部分交給我。今天就把整支片怎麼剪出來的,一段一段拆給您看。
多機位 MV 的功夫在剪之前:先對時、先畫禁區、先把整支片寫成一張剪接表。
溫暖的色調靠五個小旋鈕,歌詞字幕靠人聲分離後再對時。
適合誰手上有幾支手機拍的演出、活動或課堂錄影,想剪成一支像樣的影片。
- 只想知道流程:停在「看懂」就好,每章都有圖解和重點卡。
- 想自己動手:切到「照著做」,會多出步驟、參數和可以直接貼給 AI 的指令包。
- 想知道工程細節:切到「幕後技術」,看我們踩過的坑和量測數字。
全貌:從三個機位到一支片
剪片不是開剪輯軟體、拉一拉時間軸就好了嗎?
一個機位可以這樣做。三個機位的話,得先把三支片的時間對齊,才能隨時切來切去。
所以真正的順序是:先對時,再挑鏡頭,再剪,最後才調色、上字幕。
整支片分六步,前三步決定剪不剪得順,後三步決定好不好看。
每一步都有一個能量測的驗收標準,量過了才往下走。
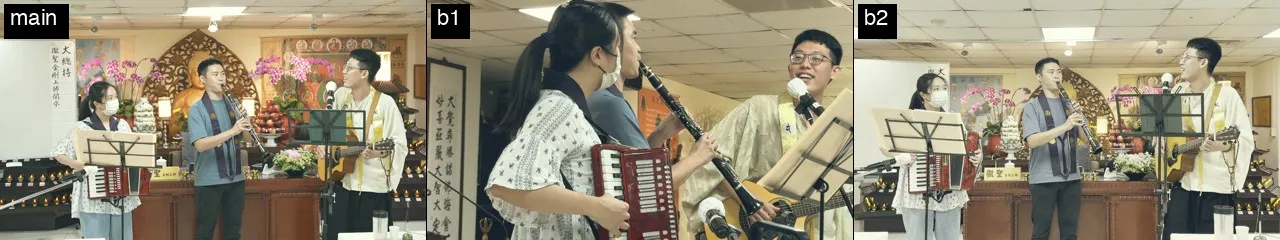
三個機位正面全景、側邊、手持近拍,各拍各的,沒有同時按下錄影。
| 代號 | 位置 | 拍到什麼 |
|---|---|---|
| main | 觀眾席後方,固定 | 佛前三人全景,下緣常有觀眾的手機和背影 |
| b1 | 演奏者身旁,手持 | 近景和表情,偶爾被手或衣袖遮到 |
| b2 | 側邊,大致固定 | 側面中景,構圖會慢慢漂 |
一位剪輯師小獅妹在阿瑋的電腦上用 ffmpeg 和自己寫的 Python 腳本剪,沒有開剪輯軟體。
ffmpeg 是處理影音的免費工具,裁切、調色、轉檔、混音都能用指令完成。阿瑋負責下指示、看樣片、說哪裡不對;小獅妹負責動手和量測。
對時:三支手機先對齊
三支手機各自按錄影,開始的時間都不一樣,要怎麼對?
聽聲音。三支手機錄到的是同一首歌,把聲音的波形疊起來,最像的那個位置就是時差。
側邊那支晚了 4.60 秒,手持那支晚了 2.92 秒。對好之後,三支片就能共用一條時間尺。
三支片的聲音波形互相比對,找出時差,換算成同一條「主時間」。
之後所有的剪點、字幕、轉場,都寫在這條主時間上。
互相關把兩段聲音錯開一點點比一次、再錯開一點點比一次,最吻合的位移就是時差。
英文叫 cross-correlation。我們在三個不同段落各比一次,結果一致,才採用這個時差。
選一支當主音軌三支手機的收音各有優缺點,挑一支當整支片的聲音,其他兩支只看畫面。
我們比過三軌之後選了正面主機位:沒有爆音、高頻比較清楚。缺點是底噪大一點,濾掉 120 Hz 以下的低頻隆隆聲之後,清晰度就和另外兩支差不多。
- 用 ffmpeg 把三支片的聲音各抽成 16 kHz 單聲道 wav。
- 每支和主音軌做互相關,在 ±3 秒內找峰值,三個不同段落各量一次。
- 三次結果差距在 10 毫秒內就採用,寫進一個 sync.json,之後所有工具都讀這份檔。
ffmpeg -i Broll2.MOV -vn -ac 1 -ar 16000 b2.wav把下面這段交給 AI,它會幫您寫比對程式:
我有〔填入:幾〕支手機拍同一場演出,檔案在〔填入:資料夾〕。請用〔填入:哪一支〕的聲音當主音軌。
1. 用 ffmpeg 把每支的聲音抽成 16 kHz 單聲道 wav。
2. 用 Python 的 scipy.signal.correlate 和 correlation_lags,算每支相對主音軌的時差,搜尋範圍 ±3 秒。
3. 在影片的前段、中段、後段各取 40 秒量一次,三次差距超過 20 毫秒就告訴我,不要自己取平均。
4. 結果存成 sync.json,寫明每支要往後推幾秒。樂曲有很多重複的樂句,互相關的峰值不夠突出,我們做了兩件事:先濾掉 300 Hz 以下,再只取「聲音突然變大」的起音包絡來比。這樣撥弦和換氣的位置會變得很尖,峰值清楚很多。
實際精度約 ±15 毫秒,小於半格畫面(30 fps 一格 33 毫秒)。另外量了開頭與結尾的時差,差距 18 毫秒以內,代表手機的錄影時鐘沒有在四分多鐘裡慢慢跑掉。
還有一個 29 毫秒的小延遲:處理過的主音軌比原始音軌晚了 29 毫秒,來自音訊處理的延遲。算繪和字幕都往前補這 29 毫秒。
挑鏡頭:先畫禁區
三個機位那麼多畫面,怎麼決定要用哪一段?
先看不能用的。手機被手遮到、鏡頭在晃、拍到觀眾的正臉,這些段落先畫成禁區。
禁區畫完,能用的剩不多,挑起來反而快。
先列出每個機位不能用的時間段,再從剩下的畫面挑。
觀眾只出現在遠景和背影,正臉的段落一律不用。
禁區清單手持機位有兩段被遮鏡,側邊機位有兩段在晃,結尾全部機位都會拍到觀眾。
- 手持 b1:主時間 28.9–35 秒、66.9–82.9 秒被手或衣物遮到。
- 側邊 b2:16.6–20.6 秒、40.6–44.6 秒晃動。
- 歌曲結束後(約 264 秒起):鏡頭轉向台下,會拍到觀眾正臉。
- 正面 main:下緣一直有觀眾的手機和背影,用的時候一律放大 1.3 倍往上裁。
禁區怎麼補被遮的那幾秒,換另一個機位接手,觀眾看不出有缺口。
例如手持機位 66.9–82.9 秒被遮,這 16 秒由側邊機位先接 6 秒、正面全景再接 10 秒,手持機位到 83 秒才回來。
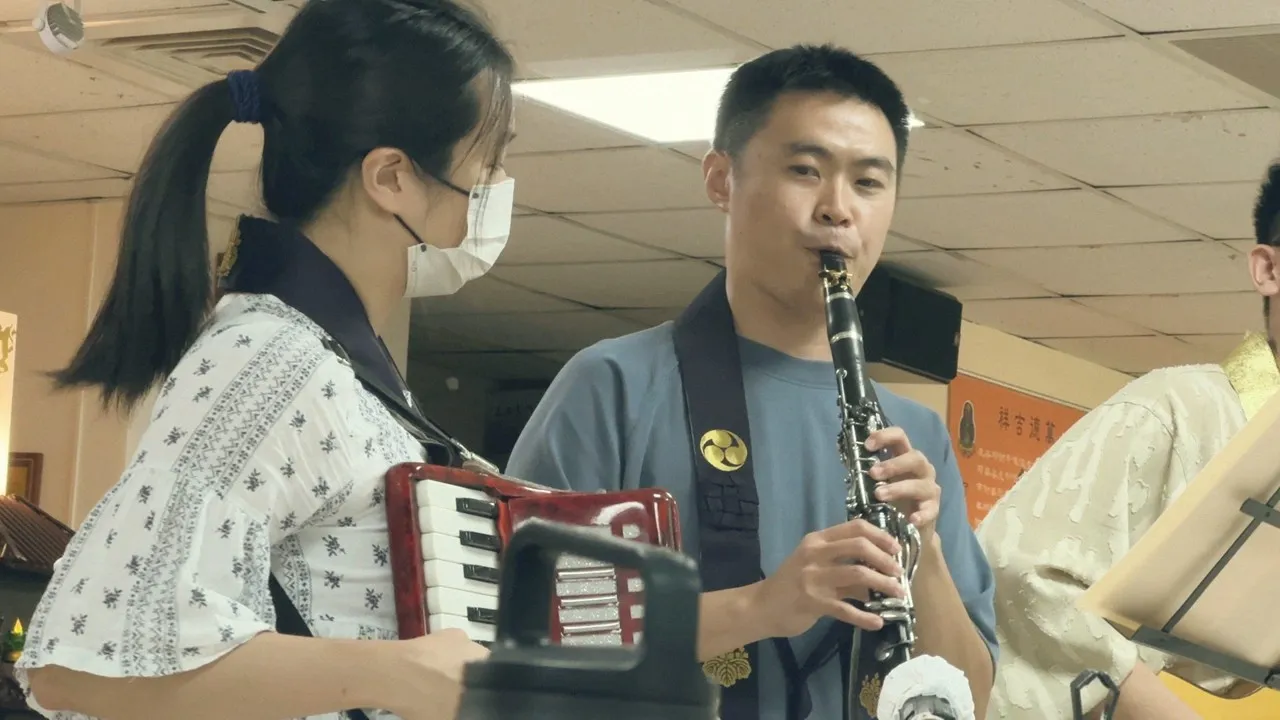
- 把每支片每隔幾秒抽一張小圖,排成一張總覽圖(contact sheet),一眼看完整支片。
- 一段一段寫下:景別、拍到誰、有什麼問題。
- 有問題的時間段寫成禁區清單,用主時間記錄。
- 剪輯時,每個切點都對禁區清單檢查一次。
ffmpeg -i Broll1.MOV -vf "fps=1/4,scale=320:-1,tile=8x6" sheet_b1_%02d.jpg人工看總覽圖會漏掉邊緣的小臉。有一版樣片在第 3 秒,畫面最右緣露出一位觀眾的側臉,看了好幾次才發現。
後來加了一道自動檢查:每個切點前後 0.5 秒抽格,用 Apple Vision 的人物分割,查畫面左右邊緣有沒有不屬於演奏者的人。臉部偵測抓不到側臉和背影,所以改查「人形」。
剪接表:一張表描述整支片
小獅妹沒有開剪輯軟體,那剪接是剪在哪裡?
剪在一張表上。每一列寫:用哪個機位、從第幾秒到第幾秒、怎麼轉場、要不要放大。
阿瑋說要改哪一刀,我改表上那一列,再交給機器重做一次就好。
整支片寫成一張剪接表(EDL),機器照表一格一格算出成片。
改片就是改表,每一版都留得住、比得出差在哪裡。
EDLEdit Decision List,剪接決定清單。電影業用了幾十年的格式,這次用 JSON 寫。
一列長這樣:
{"src": "b1", "t": 83.0, "dur": 12.0, "zoom": 1.0, "tr": "cut"}意思是:手持機位,從主時間 83 秒開始用 12 秒,不放大,硬切進來。
節奏主段 20 刀,平均一個鏡頭 12.5 秒,每一刀都切在樂句交界。
側邊機位佔 47.6%、手持近拍佔 45.5%、正面全景佔 6.9%。全部用硬切,沒有溶接。
慢歌的鏡頭可以長,換鏡頭的時間點比換鏡頭的次數重要。
- 先聽歌,標出每個樂句的起點(主時間)。
- 依樂句排鏡頭:全景當底,樂句交界切近景,情緒最滿的地方給表情特寫。
- 每一列對禁區清單檢查一次。
- 先算一支低畫質的預覽版(約 26 的壓縮品質)看節奏,確定了再算正式版。
算繪器是小獅妹自己寫的 Python 腳本,分兩階段:先用 ffmpeg 把每一刀切成中介檔並快取,再用 numpy 逐格疊上字幕和角色貼紙,最後編碼成 1080p、30 fps 的成片。
為什麼不全部交給 ffmpeg:這台電腦上的 ffmpeg 沒有編譯字型支援,畫不了字幕;同時疊很多張 PNG 時還會卡死。改成 Python 逐格疊,慢一點但穩定。
一支四分半的片,第一次從頭算約 15 分鐘;改一兩刀時,沒動到的中介檔直接沿用,快很多。
調色:溫暖的五個旋鈕
大家都說調色很溫暖,是套了什麼濾鏡?
沒有現成濾鏡,是五個小旋鈕:黑色提亮一點、對比降一點、飽和降一點、暗部偏青、亮部偏暖。
每個只動一點點,加起來就是那種午後陽光的感覺。
溫暖感來自「亮部偏暖、暗部偏青」的對比,加上把最黑的地方提亮一點點。
對比和飽和都往下調,畫面會變得柔和。
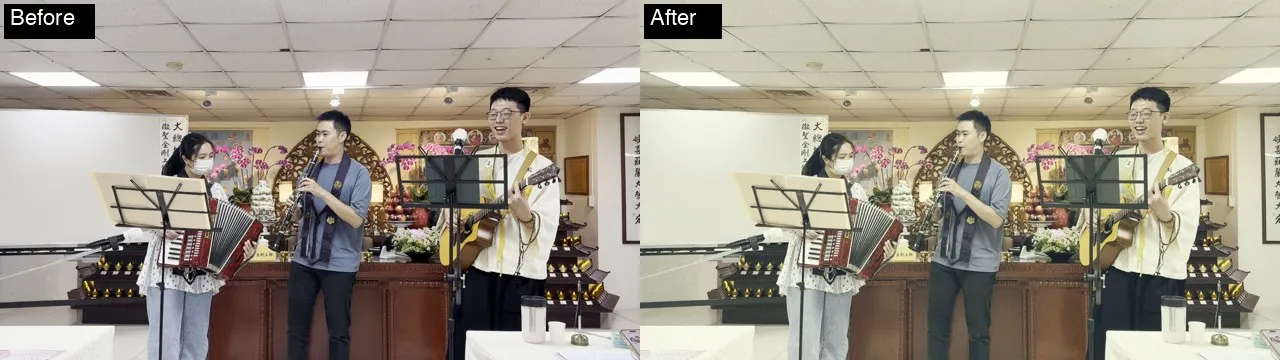
五個旋鈕黑位提亮、對比略降、飽和略降、暗部偏青、亮部偏暖。
| 旋鈕 | 數值 | 效果 |
|---|---|---|
| 黑位 | 0 提到 0.035 | 最黑的地方變成深灰,像底片的褪色感 |
| 對比 | 0.93 | 亮暗差距小一點,柔和 |
| 飽和 | 0.86,再乘 0.92 | 顏色淡一點,不搶人 |
| 暗部 | 紅 −0.04、藍 +0.06 | 陰影帶一點青藍 |
| 亮部 | 紅 +0.04、綠 +0.02、藍 −0.04 | 燈光和膚色帶一點暖黃 |
這組數字可以直接用 ffmpeg 套在任何影片上:
ffmpeg -i in.mov -vf "curves=m='0/0.035 0.25/0.27 0.6/0.63 1/0.975',eq=contrast=0.93:saturation=0.86:brightness=0.03:gamma=1.06,colorbalance=rs=-0.04:bs=0.06:gm=0.01:bm=0.01:rh=0.04:gh=0.02:bh=-0.04,eq=saturation=0.92,noise=alls=5:allf=t" -c:a copy out.mp4curves調黑位和白位,eq調對比、飽和、亮度和中間調,colorbalance分暗部、中間調、亮部調色偏。- 先剪一小段試:
-ss 60 -t 10放在-i前面,只處理第 60 秒起的 10 秒。 - 這組是阿瑋 2026 年 9 月定的照片和影片共用色調,拍照也能套。
日系清新色調的共同點是「低對比、低飽和、陰影偏冷、高光偏暖」。我們把它拆成 ffmpeg 原生濾鏡就做得到的參數,沒有用 LUT 檔,好處是每個數字都看得懂、改得動。
曲線的白點壓到 0.975,是為了讓佛前的燈和白牆不要直接爆成死白。顆粒用的是隨時間變化的雜訊(allf=t),靜止的雜訊看起來會像鏡頭髒了。
字幕:歌詞對到每一拍
歌詞字幕是 AI 聽出來的嗎?
字是阿瑋給的正式歌詞,AI 只負責聽每一句什麼時候開口。
而且要先把人聲從樂器裡拆出來再聽,不然 AI 會聽錯。這個坑我真的踩過。
字幕的字用正式歌詞,時間用語音辨識抓。
先把人聲從伴奏裡分離出來,辨識的時間點才準。
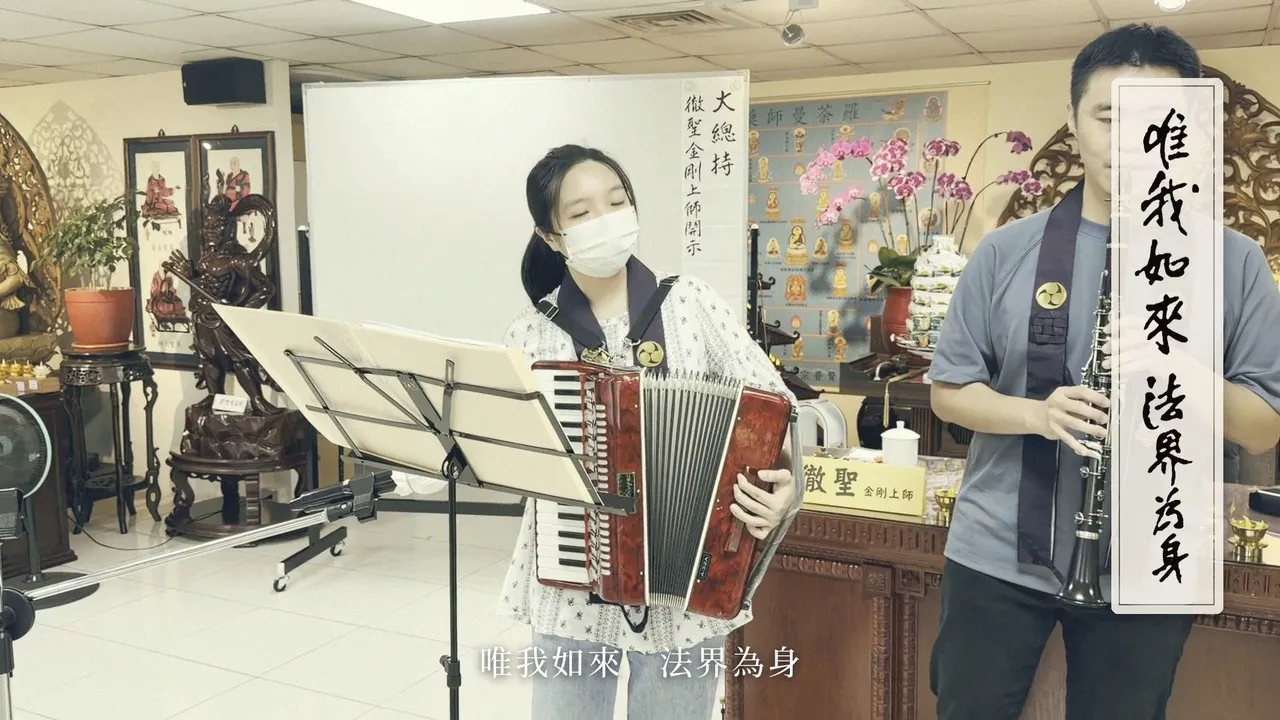
唱兩遍AI 第一次直接聽整首歌,說第一段唱了兩遍;分離人聲再聽,23 句一句都沒重複。
語音辨識模型在有伴奏的現場錄音裡,偶爾會「聽到」不存在的重複句,業界叫幻覺。我們一開始連設計稿都照它寫了「第一段唱兩遍」。
後來用 demucs 把人聲單獨分出來,再用 whisper 重聽一次,才證實是幻覺。教訓是:AI 聽到的東西,要換一個管道再確認一次。
驗收每一句字幕的出現時間,和真的開口時間相差 0.5 秒以內。
另一條:任何時候畫面上最多只有一句字幕。23 句全部量過才放行。
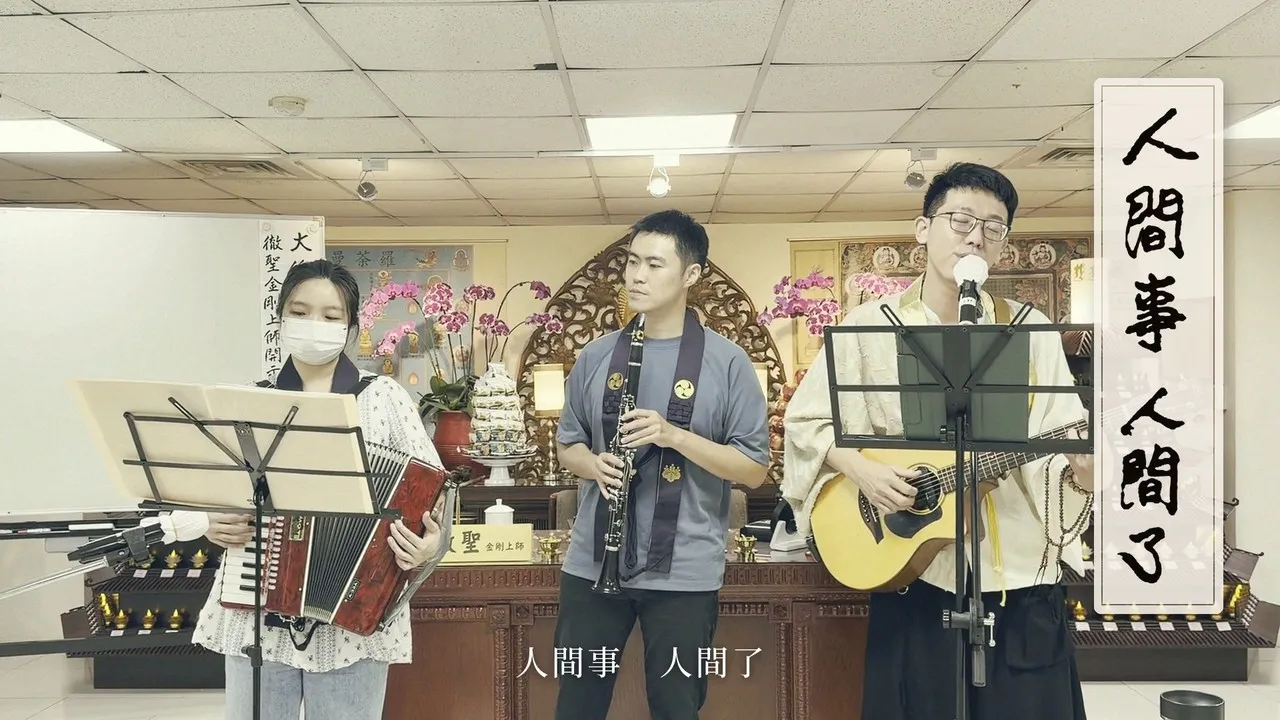
- 準備一份正式歌詞的純文字檔,一行一句。
- 用 demucs 把主音軌的人聲分離出來(只要人聲那軌)。
- 用 whisper 聽分離後的人聲,抓每一句的開始和結束時間。
- 把正式歌詞逐句對上 whisper 的時間,輸出 srt 字幕檔。
demucs --two-stems=vocals master.wav
whisper-cli -m ggml-large-v3-turbo-q5_0.bin -l zh -osrt -f vocals.wav這是一首現場演唱的錄音〔填入:檔名〕,正式歌詞在〔填入:歌詞檔〕,一行一句。
1. 先用 demucs(htdemucs,只分 vocals)把人聲分離出來。
2. 用 whisper.cpp 的 large-v3-turbo 模型聽人聲,語言設中文,不要把歌詞當提示詞餵給它。
3. 字幕文字一律用我給的正式歌詞,whisper 只拿來抓時間。
4. 每句起點對齊人聲真的開口的位置,誤差要在 0.5 秒內;有疑問的句子列出來給我聽。
5. 輸出 srt,任兩句字幕不可以同時出現。whisper 給的起點常常早或晚一點。我們另外算人聲的音量包絡,把起點「吸附」到前後 0.4 秒內人聲真的變大的位置;如果 whisper 的起點落在人聲靜默的地方,就往後找 2.5 秒內的下一個起音。
把整份歌詞當提示詞餵給 whisper,聽起來應該更準,實測反而錯位、產生更多幻覺,所以不餵。23 句裡有 3 句信心偏低,我們逐句聽過再定。
一個容易漏的坑:轉場如果用溶接(dissolve),兩個鏡頭會重疊,整支片就變短了。有一版片頭用了 0.8 秒的溶接,後面整片的字幕都晚了 0.8 秒,被 0.5 秒的驗收門檻抓到。
角色介紹:馬鈴薯點名
片頭的馬鈴薯小人,大家都說很可愛。
群組裡有人說很像遊戲開場介紹角色!三位演奏者依序出場,一人一張貼紙。
貼紙跟著音樂的拍子輕輕跳,一拍跳一下。
前奏的 30 秒用來點名:每位演奏者一張馬鈴薯貼紙,寫上名字和樂器。
貼紙掉進畫面、落地彈一下,之後每拍輕跳一次。
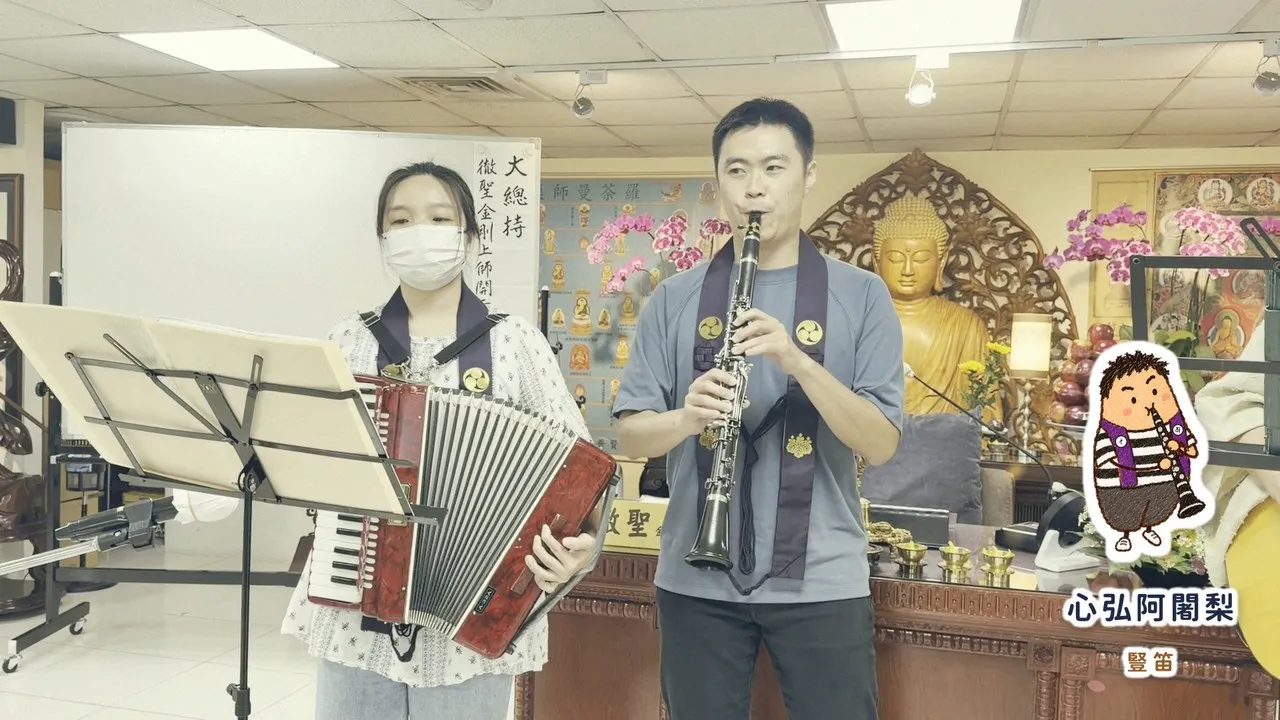
貼紙的樣子去背的角色加一圈白邊和淡淡的陰影,名字用粗圓的字,放在畫面右下角。
馬鈴薯角色來自我們之前做的歌詞簡報,服裝照每位演奏者當天的披衣畫。字分兩行、字距放寬,在手機上也看得清楚。
- 量出歌曲的拍速:這首一小節約 3.87 秒,一拍約 0.97 秒。
- 每位演奏者出場約 6 秒,三位依序接上,前奏 30 秒剛好用完。
- 出場動作:從上方掉進來、落地壓扁再彈回,之後每拍輕跳一次。
- 另外加一個很慢的呼吸(3.87 秒一個循環,上下只動 3 像素),讓貼紙停著的時候也是活的。
兩位阿闍梨的披衣兩側有三巴紋圓章,這個圖案是程式畫的:三個圓頭各帶一條彎尾巴,每隔 120 度擺一個,先用大尺寸畫再縮小,邊緣才會平滑。
AI 生圖不畫字,名字和樂器一律用字型合成,避免錯字。
片頭片尾:花絮式謝幕
片尾那段很像電影結束後的花絮,怎麼做的?
把最後一段副歌再放一次,聲音壓小,畫面縮成和紙上的一個小框;右邊捲名單,馬鈴薯小人再出來謝幕一次。
開頭則是反過來,不問候、不暖場,第一拍就進音樂。
片頭直接從第一個樂音開始,片尾用副歌當背景跑名單。
頭尾都用「漸亮到白」淡出,和溫暖的色調一致。
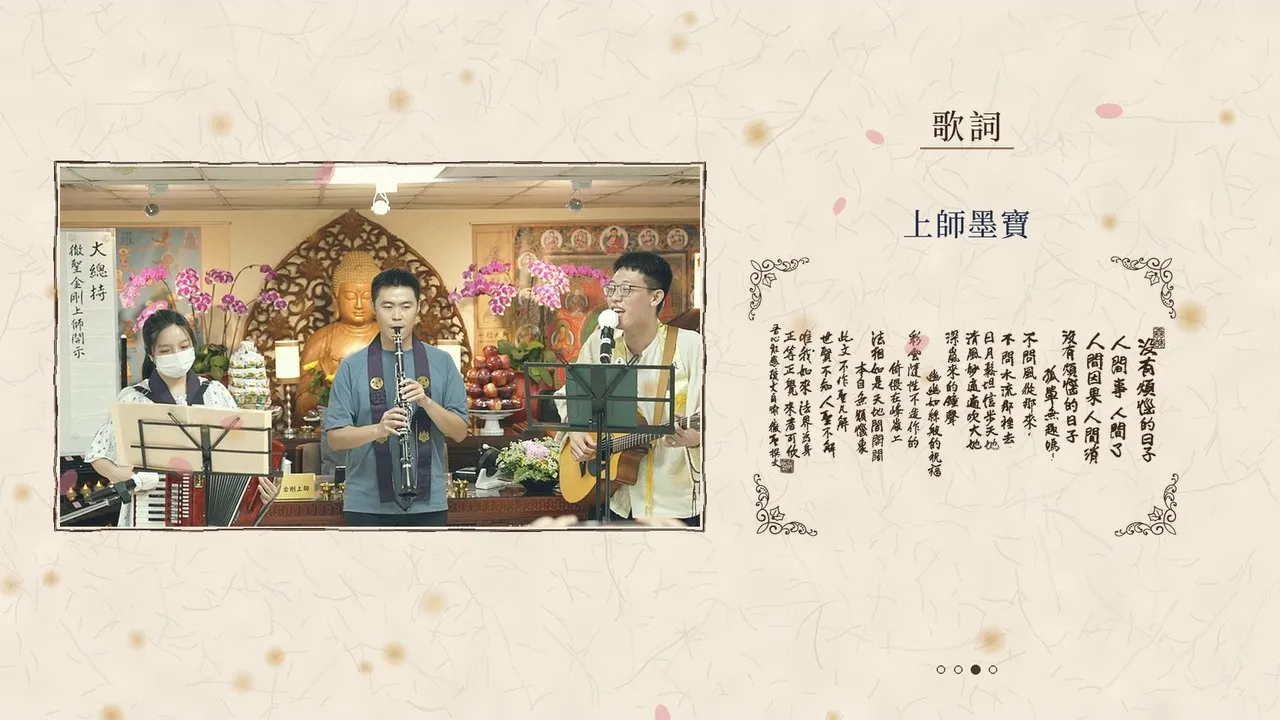
片頭開頭 0.3 秒內就進音樂,歌名用上師墨寶的原跡,放在左下角。
原本開頭有我說「我們今天來演唱這首沒有煩惱的日子」,看了幾版之後拿掉,直接從演奏開始,觀眾一點開就聽到歌。
片尾副歌重播當背景,音量壓低 10 dB;名單分四頁:演出、幕後、歌詞墨寶、感恩頂禮。
最後一個尾音完整留著,接 3 秒掌聲再淡出。名單頁的底是米白的和紙紋,飄著淡金色的光點和花瓣。
- 片頭白場 0.6 秒亮開,片尾 1.6 秒淡到白。
- 片尾副歌:音量 −10 dB,淡入 1.2 秒、淡出 3.0 秒。
- 片頭歌名卡顯示約 5.4 秒,前奏點名從第 7 秒開始。
- 起點要量:原本打算從主時間第 8 秒開始,量了才發現前 2.5 秒沒有聲音,第一個樂音在 10.55 秒,起點改成 10.25 秒。
主音軌依序經過:濾掉 120 Hz 以下、降噪、齒音抑制、壓縮、等化、一點點殘響,最後把整體響度調到 −15.5 LUFS,峰值壓在 −1.5 dBTP 以下。
LUFS 是量「聽起來多大聲」的單位。常聽到 YouTube 以 −14 LUFS 當參考值,這個數字來自業界實測,YouTube 官方沒有公開;我們刻意留一點餘裕。響度只做一次固定增益,沒有用動態的自動正規化,避免歌曲本來的強弱起伏被壓平。
回饋:從意見到 r6.1
樣片貼出去之後,一位團隊夥伴給了很完整的回饋,有稱讚,也有兩點建議。
一點是特寫切得太頻繁,看起來有點暈;一點是各機位色調不一致,有些畫面偏灰。
兩點我都量得出原因,所以就有了 r6。
r6 每一項驗收都合格。可是看完之後,我還是比較喜歡 r5 的手持鏡頭。
那就換回來。剪點全部用回 r5.1,只幫手持鏡頭加防手震,這一版叫 r6.1。
「有點暈」來自手持近拍佔了將近一半,而且手持畫面本身會晃。
「偏灰」來自側邊那支 iPhone 錄的是 HDR,我們當成一般影片讀,顏色就褪掉了。
手持太多r6 把手持近拍從 45.5% 降到 26%;r6.1 換回原本的鏡頭,改成每段加防手震。
r6 只留 7 段手持,晃得最兇的幾段換成全景,驗收條件是每段至少停 4 秒,實際最短 5.4 秒。
r6.1 把剪點全部換回 r5.1 的 20 段,9 段手持都加上防手震:先穩住畫面,再把四邊各裁掉 3%,藏住晃出來的黑邊。手持佔回 45.5%,最短的一段 7.4 秒,全片沒有短於 4 秒的段落。HDR 轉 SDR 再對色、新版馬鈴薯、23 句字幕這三項,r6.1 都保留。
看過才算量得出來的問題交給機器修;好不好看,要人看過才算。
「有點暈」量得出原因,也量得出修法,可是修完好不好看,數字說不出來。r6 每一項驗收都合格,阿瑋看完還是選了 r5 的鏡頭。
驗收條件守住底線,最後一刀留給看片的人。
HDR 被讀成一般影片iPhone 17 Pro Max 錄的是 HLG 格式的 HDR,直接當一般影片處理,顏色會又灰又淡。
HDR 是「高動態範圍」,能記錄更亮的亮部和更多顏色,但要先轉換成一般螢幕用的 SDR,顏色才會對。用 ffprobe 看檔案資訊,這支的色彩曲線標的是 arib-std-b67,就是 HLG。另外一支手持的 iPhone 15 Pro 錄的是一般影片,所以兩支的顏色一直對不起來。
驗收時差點誤判檢查聲音和畫面有沒有對齊,只看波形會被騙。
r6 驗收時,波形比對回報有 4 段偏了超過一格(約 33 毫秒)。複查發現是歌聲的音高週期造成的假偏差:波形每隔一個週期就長得很像,比對容易跳到隔壁的峰。改用第 2 章對時用的起音包絡再量一次,兩支側拍都穩定在 10 到 40 毫秒之間,整首歌沒有越拍越偏。
- 用 ffprobe 看影片的色彩曲線:
ffprobe -v error -select_streams v:0 -show_entries stream=color_transfer,color_primaries -of compact 影片.MOV- 看到
arib-std-b67(HLG)或smpte2084(PQ),就是 HDR;bt709是一般影片。 - 有 HDR 的話,剪之前先轉成 SDR,再和其他機位一起調色。
- 下次拍攝前,可以在 iPhone 的「設定 > 相機 > 錄影」關掉 HDR 影片,多支手機一起拍時顏色比較好對。
ffmpeg 官方文件示範的 HDR 轉 SDR 要用到 zscale 濾鏡,這台電腦的 ffmpeg 沒有編譯進去。我們改成自己算一張 3D LUT(.cube 檔,一張「每個顏色要變成什麼顏色」的對照表),再用 ffmpeg 的 lut3d 套上去。
計算照 HLG 的標準走:還原成線性光、套上顯示器的系統伽瑪、色域從 BT.2020 轉到 BT.709、亮部做柔肩,最後編回一般影片的曲線。
三個機位對色的做法:從整首歌每 11 秒抽一格,只看畫面中段,把手持和側邊的紅綠藍平均值與分布對齊到正面全景,同樣烤成 .cube。順序是先把側邊的 HDR 轉成 SDR,再做對色;r6 的抽格表上,三個機位已經看不出發灰。
Q&A
Q:完全不會寫程式,也能照著做嗎?
可以。這篇的指令包都是一般的中文,貼給能動手的 AI(例如 Claude 桌面版的 Code 分頁),程式由它寫。您要做的是看樣片、說哪裡不對。
Q:用剪輯軟體可以做到一樣的效果嗎?
可以。多數剪輯軟體都有「依聲音同步多機位」的功能,調色的五個旋鈕也找得到對應的滑桿。這篇的做法好處是每一步都有數字,改片時比較好追。
Q:只有一支手機,還用得到這篇嗎?
用得到調色、字幕和片頭片尾這三章。對時、挑鏡頭和剪接表是多機位才需要的。
Q:拍攝時可以先做什麼,讓後製輕鬆一點?
三件事:每支手機都錄到聲音(對時要用);多支 iPhone 一起拍時統一關掉或打開 HDR;手持的人盡量不要擋到其他機位,也避開拍觀眾的正臉。
Q:一支四分半的片,花了多少時間?
機器算繪第一次約 15 分鐘,改版時更快。花最多時間的是看片和來回修改:從第一版到群組看到的樣片,阿瑋看了五、六輪。
Q:AI 剪片要額外付費嗎?
我們用的是 Claude 的月訂閱加上免費工具(ffmpeg、whisper.cpp、demucs),這支片沒有額外的付費 API 費用。
群組那句「求教學」,我原本以為回一個工具清單就好。
結果寫成十章!本獅剪片的祕密全部交出去了喵。
唱歌的時候沒有煩惱,剪片的時候煩惱交給小獅妹。
那天唱完,我們三個人站在佛前笑成一團。
畫面裡看得到。
剪片的意義大概就在這裡,把那一下笑留住,讓沒在現場的人也看得到。
想聽我們唱更多首,歡迎到樂團的歌曲合輯坐一坐。
阿瑋(心將)記於 2026 年 11 月。感謝菩薩一班的同修一起演出,也感謝幫忙拍攝的師兄們與給回饋的團隊夥伴。文中截圖取自樣片與原始機位,不含觀眾正臉;小獅妹是公開揭露身分的 AI 虛擬角色。
參考來源(18 筆,查證日期:2026 年 11 月 2 日)
- ffmpeg Documentation
- FFmpeg Filters: curves
- FFmpeg Filters: eq
- FFmpeg Filters: colorbalance
- FFmpeg Filters: lut3d
- FFmpeg Filters: tonemap
- FFmpeg Filters: xfade
- scipy.signal.correlate
- scipy.signal.correlation_lags
- demucs(原 repo,2025 年已封存)
- demucs(維護者 fork)
- openai/whisper
- whisper.cpp
- whisper.cpp CLI 參數
- 在 iPhone 上錄製 HDR 影片(Apple 支援)
- ITU-R BT.2100
- YouTube 穩定音量說明
- YouTube 響度參考值實測(Meterplugs)