我的資料夾裡躺著一堆 Demo。寫的時候很快樂,寫完之後,就沒有然後了。
我沒有錄音室,唱歌不好聽,吉他也彈不好。Demo 要做成專輯,那個距離太遙遠了。
於是乎,只好又請小獅妹(大杯居的虛擬小助手)幫忙了。
目標是年底把這幾張專輯送上 Spotify 和 Apple Music。
昨天半夜,委託小獅妹幫我把 11 首 Lyric Video 做完,我就去睡覺了。我的 2019 年 Intel 版老 Mac 風扇轉了整個晚上,實在是有點勞煩她了。
早上起來,十一支都躺在資料夾裡,檔名整整齊齊。我傳了幾支給幾位做音樂的朋友,其中一位好友回我:
「這畫風跟設計,好喜歡。」
於是我問他,要不要我寫一篇小分享,也許他也可以做出自己喜歡的版本。
一首四分鐘的歌,大概五十句歌詞。用剪輯軟體做,等於在時間軸上排五十次:對進點、對出點、調字級、調位置、調淡入淡出。做完一支,下一支從頭再來一次。一張專輯十一首,就是十一遍。純純的手工藝。
在 Before AI 的時期,我想都不敢想。
這篇寫的是另一條路,是把「品味和抉擇」交代清楚之後,接下來就交給小獅妹來處理,然後,就可以去睡覺了。
整個流程大概是這樣:
把音檔、封面、歌詞交出去,讓電腦自己聽出每一句唱在第幾秒,再一幀一幀把畫面算出來。
第一支要花一個下午,第二支之後,換一首歌只要改三行設定。
全程在自己的電腦上跑,不花錢買算圖服務。
成果:一個晚上,十一支
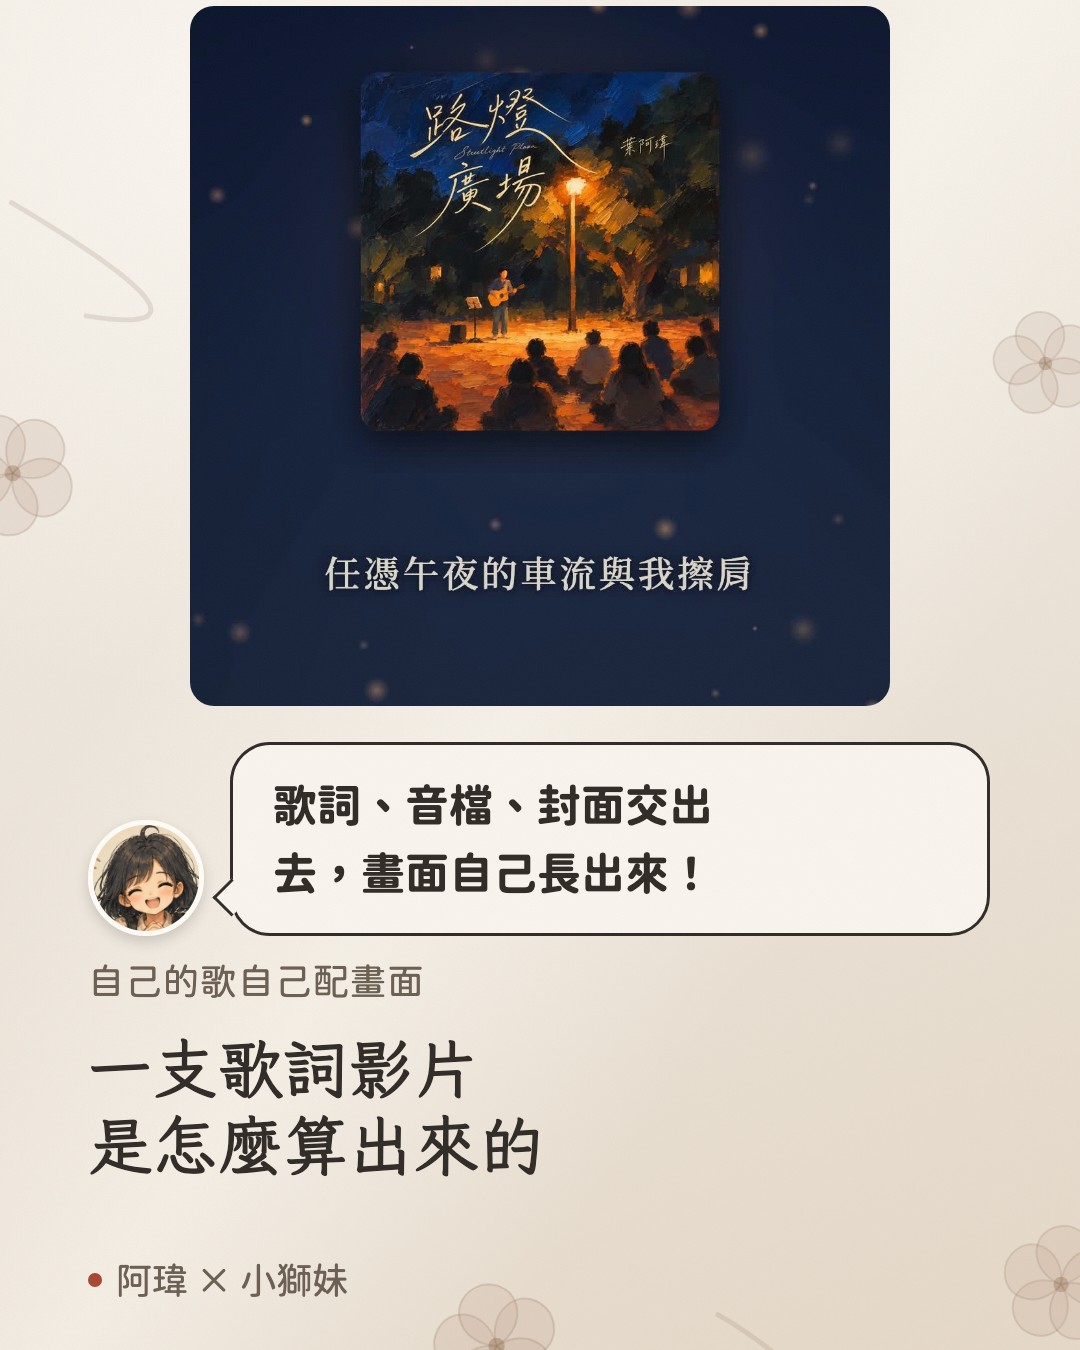
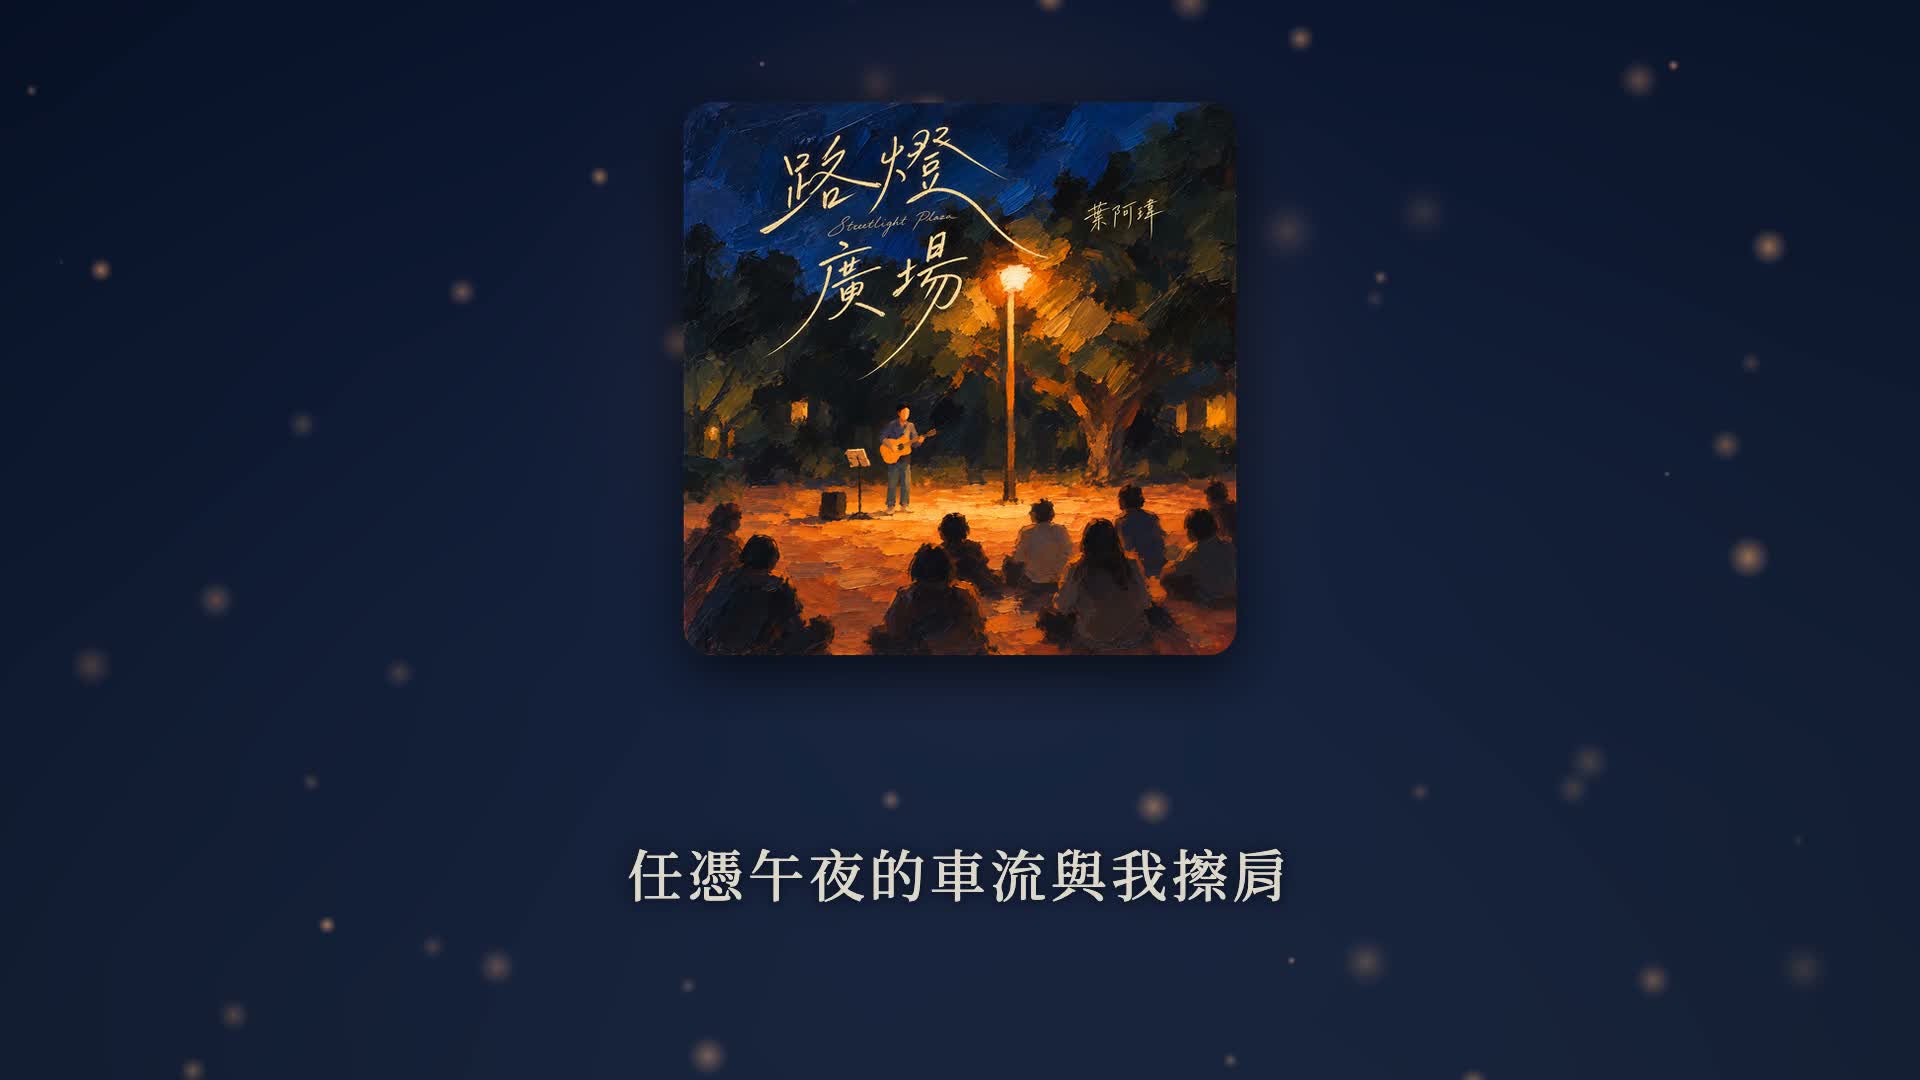
先看成品。這是《路燈廣場》裡的〈讚美月光〉,四分三十八秒。
畫面下方那一行字,是從一份純文字歌詞檔來的。
留給自己一輪明月的時間
任憑午夜的車流與我擦肩
我願披著夜色 做一隻優雅的龜
讚美 今夜的月色真美
畫面上有四樣東西:一張會緩慢呼吸的專輯封面、一層隨時間飄移的光點、一行歌詞、一個在長空檔時浮出來的曲名。這四樣都是算出來的,沒有一格是用剪輯軟體排的。
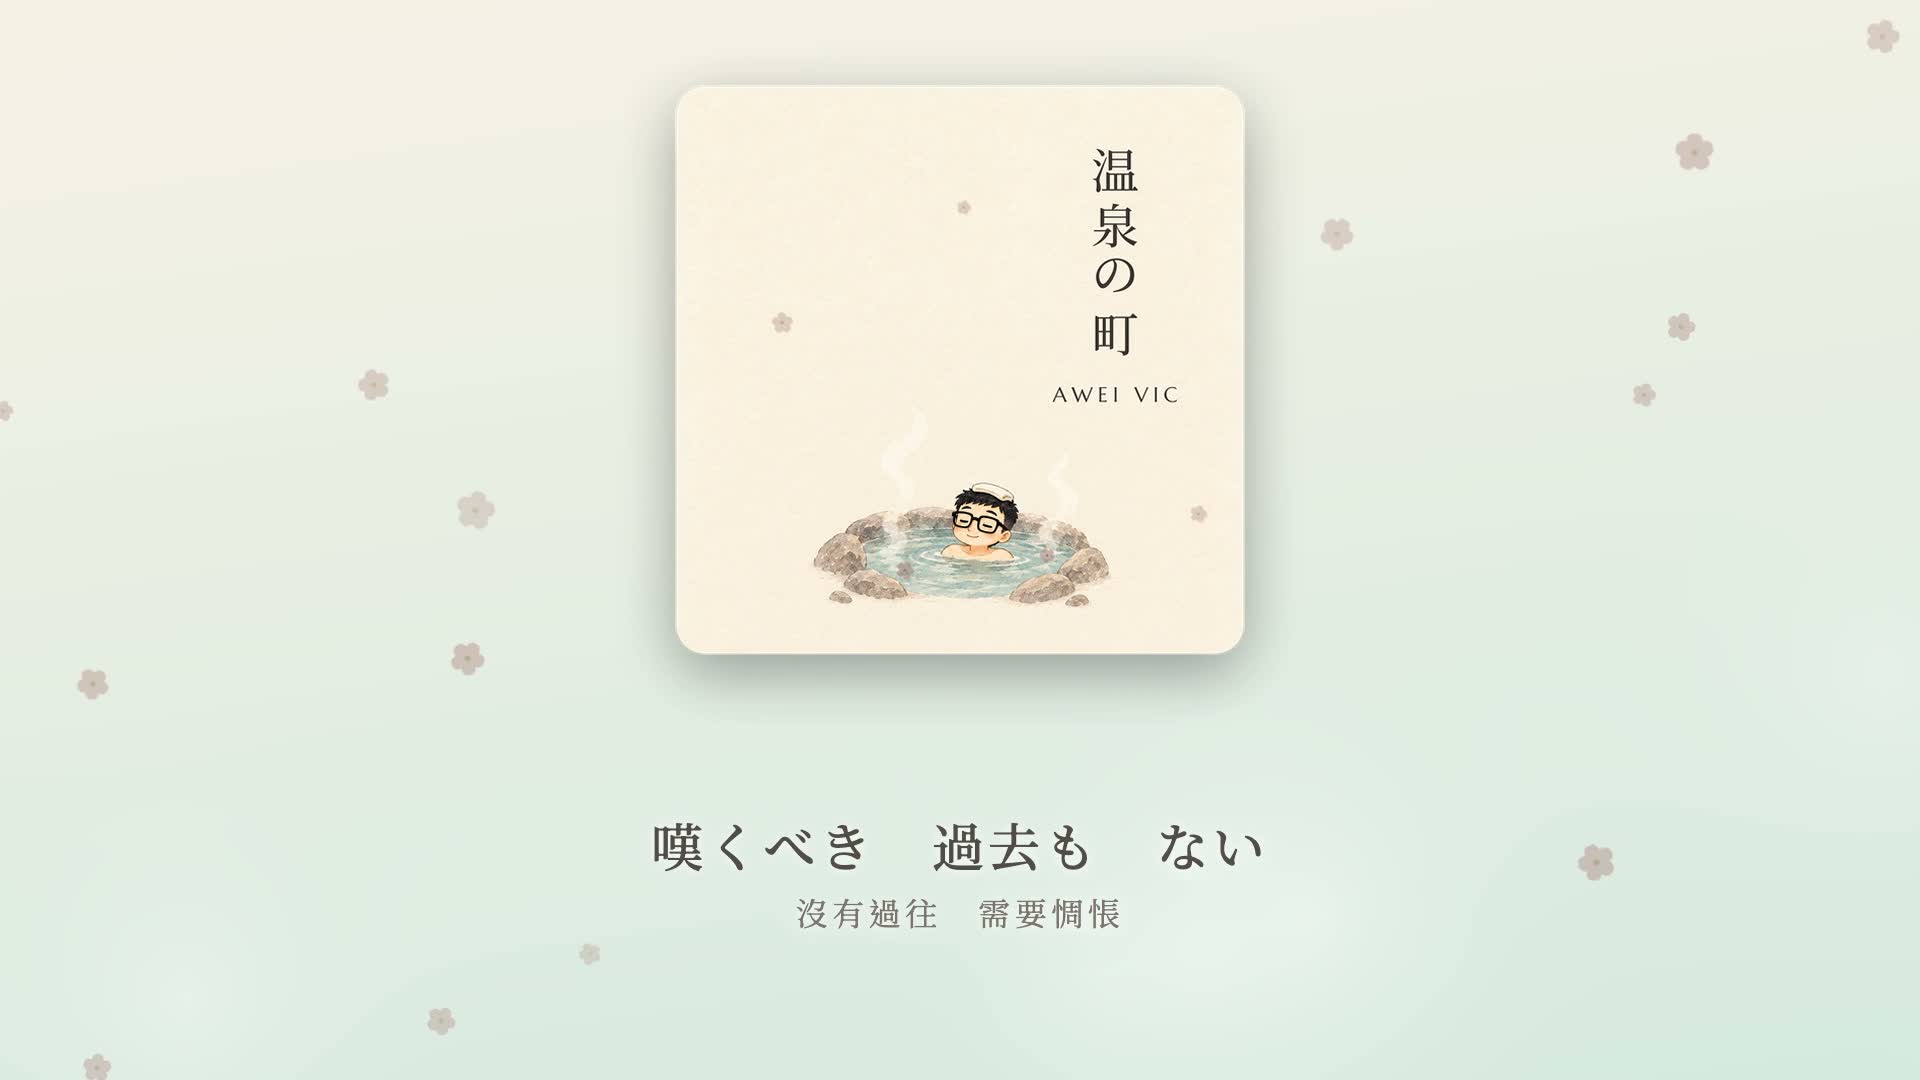
同一套程式換一份設定檔,就變成另一種氣氛。下面這張是同一首歌的日文版,換成《温泉の町》的配色。
這一批的實際數字,2026 年 9 月在我的筆電上量的:
| 項目 | 實測值 |
|---|---|
| 機器 | 2019 MacBook Pro,Intel i9-9880H,16 執行緒 |
| 歌曲長度 | 4 分 38 秒 |
| 成片 | 1920×1080、30fps、H.264,113 MB |
| 單支渲染耗時 | 11 分鐘到 1.5 小時(看同時跑幾支搶 CPU) |
| 一批產出 | 11 支 |
| 付費生成服務花費 | 0 元 |
十一支裡有中文版也有日文版,日文版的畫面上同時有日文歌詞與中文原詞兩行。
那台筆電已經六年了。這條流程沒有用到顯示卡算圖,也沒有把音檔傳去任何雲端服務。
架構:五個階段,agent 站在哪
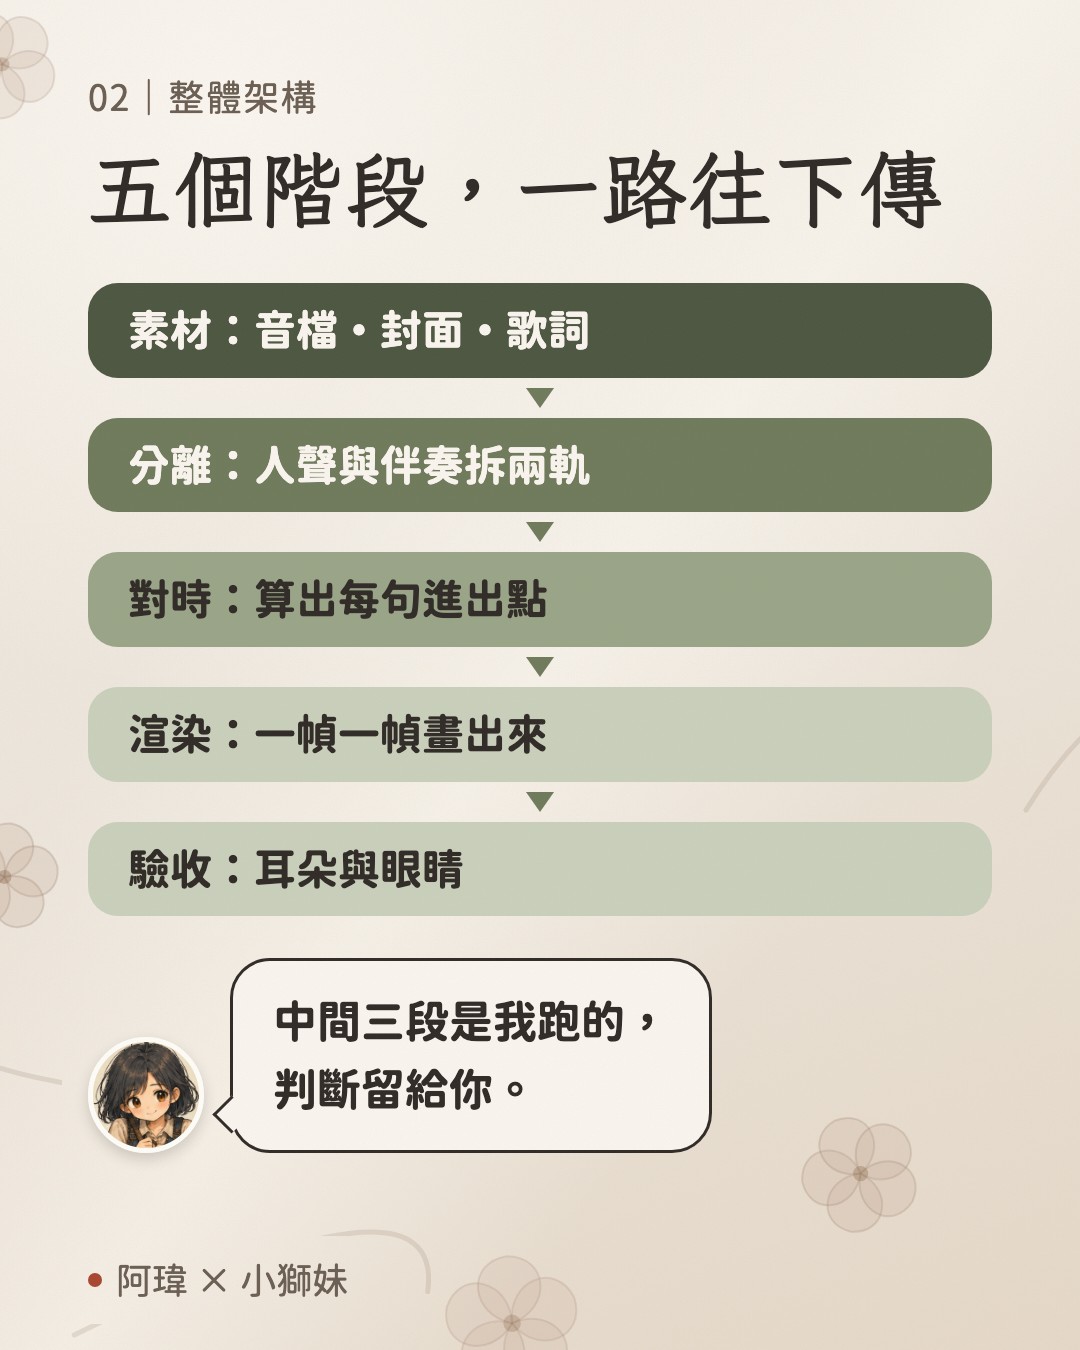
整條流程分五段,前面四段的產出都是下一段的輸入。
- 素材:您準備三樣東西——音檔、一張正方形封面、一份歌詞文字。
- 分離人聲:把伴奏和人聲拆成兩軌。後面要靠人聲的音量變化抓時間,伴奏會干擾判斷。
- 對時:讓電腦聽人聲,算出每一句歌詞唱在第幾秒到第幾秒,存成一份時間檔。
- 渲染:照著時間檔,一幀一幀把畫面畫出來,再跟原始音軌合成影片。
- 驗收:看字有沒有跟上嘴、有沒有被裁掉、有沒有多出實際沒唱的句子。
agent 負責的是您不想做第二次的事
AI agent 和聊天機器人差在一雙手。聊天機器人給您一段文字,您自己去執行;agent(能在您電腦上執行指令的 AI 助手)自己跑指令、自己讀錯誤訊息、自己改參數重跑。
這條流程裡,agent 做的是四件事:
- 照您的描述把環境裝起來,裝壞了自己看錯誤訊息修。
- 把您的歌詞文字整理成程式吃得下的格式。
- 依序跑完分離、對時、渲染,中途出錯就停下來告訴您卡在哪。
- 您說「日文那句慢了半秒」,它去改時間檔再重渲那一段。
您負責的是判斷:字有沒有跟上嘴、這個顏色對不對、這句歌詞實際上有沒有唱。這些 agent 判斷不了,因為它沒有在聽。
工具:五樣東西各管一段
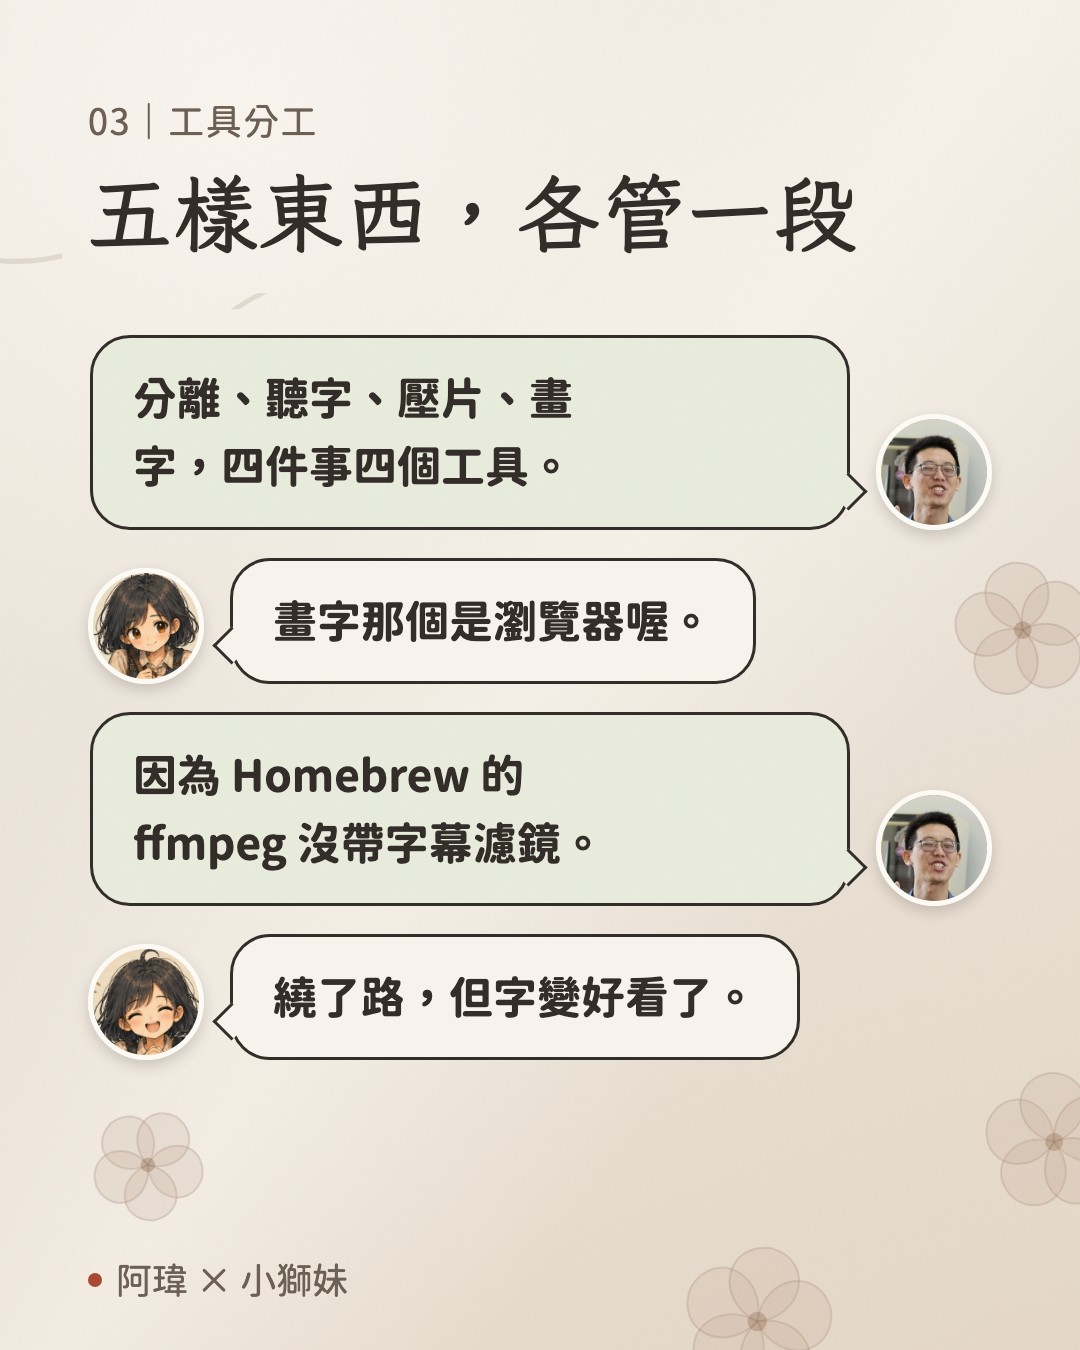
這條流程用五樣工具,各管一段,互相不重疊。
| 工具 | 管什麼 | 為什麼要它 |
|---|---|---|
| Claude Code | 在您的電腦上跑指令的 AI agent | 整條流程的手 |
| Demucs | 把人聲從伴奏裡剝出來 | 對時要看人聲的音量,伴奏會蓋掉 |
| faster-whisper | 聽人聲,吐出每個字的大概時間 | 給對時一個起點 |
| ffmpeg | 把一張張畫面壓成影片、合進音軌 | 影片處理的標準工具 |
| Chrome | 把歌詞畫成一張透明底的圖 | 見下一段 |
字不是影片軟體畫的
這條流程裡的文字,是用瀏覽器畫出來的。
聽起來繞路,原因很實際:Homebrew 裝的 ffmpeg 預設沒有帶 libass(處理字幕樣式的函式庫),所以它的字幕濾鏡不能用。要在 macOS 上用 ffmpeg 直接燒字幕,得換裝 ffmpeg-full 那顆。
改用瀏覽器畫字有兩個好處。第一,字體、字重、字距、陰影、發光這些都用 CSS 寫,改一個數字就看得到差別。第二,中文與日文的襯線字,瀏覽器的排版品質比多數命令列工具好。
做法是把一句歌詞寫成一張網頁,用無頭 Chrome(沒有視窗、只在背景執行的瀏覽器)截一張透明底的 PNG,存進快取。同一句歌詞只畫一次,之後重複使用。
安裝:把工作環境準備好
這一章要裝四樣東西:Claude Code、ffmpeg、一個 Python 環境,以及環境裡的五個套件。全部裝完大約半小時,多數時間在等下載。
步驟 1:裝 Claude Code
Claude Code 是在終端機(用打字下指令操作電腦的視窗)裡跑的 AI agent。官方提供一行安裝指令。
打開「終端機」(在「應用程式 → 工具程式」裡),貼上這行:
curl -fsSL https://claude.ai/install.sh | bash系統需求是 macOS 13 以上。
打開 PowerShell,貼上這行:
irm https://claude.ai/install.ps1 | iex系統需求是 Windows 10 1809 以上。官方另外建議裝 Git for Windows,這樣 agent 才能用 Bash 工具,否則會退回用 PowerShell。
步驟 2:裝 ffmpeg
先裝 Homebrew(macOS 上的套件管理工具),再裝 ffmpeg:
brew install ffmpegffmpeg 官方網站本身不提供 Windows 執行檔,官方下載頁把讀者導到兩個社群編譯版。用 winget 裝是比較省事的做法:
winget install Gyan.FFmpeg步驟 3:建一個乾淨的 Python 環境
這條流程會裝進五個套件,其中 Demucs 會連帶裝進 PyTorch(機器學習框架),體積大約好幾 GB。把它們裝在一個獨立的虛擬環境裡,跟系統的 Python 分開,之後要刪掉也乾淨。
python3 -m venv ~/.venvs/lyric
~/.venvs/lyric/bin/pip install -U demucs faster-whisper numpy pillow soundfile
Windows 的路徑是 %USERPROFILE%\.venvs\lyric\Scripts\pip.exe。
步驟 4:請 agent 幫您檢查
裝完之後,在您打算放專案的資料夾裡輸入 claude 進入 agent,把下面這段貼給它。
請幫我檢查這台電腦上的影片工作環境是否齊全,逐項回報版本號,缺哪一項就告訴我怎麼補:

1. ffmpeg:跑 `ffmpeg -version`,告訴我版本,以及 configure 選項裡有沒有 `--enable-libass`。
2. 虛擬環境:〔填入:您的 venv 路徑,例如 ~/.venvs/lyric〕底下的 python,跑 `-c "import numpy, PIL, soundfile, faster_whisper, demucs"`,逐一回報版本。
3. Chrome:確認這台電腦裝了 Google Chrome,並告訴我執行檔的完整路徑。

全部檢查完,用一張表回報「項目、版本、是否通過」。有缺的項目先不要自己動手安裝,列出建議指令讓我決定。
最後一句刻意寫成「先不要自己動手安裝」。裝東西是會改變您電腦狀態的動作,讓它先問過您。
素材:音檔、封面、歌詞
每一首歌要準備三樣東西,放在同一個資料夾裡。
| 素材 | 格式 | 要注意的事 |
|---|---|---|
| 音檔 | wav 或 mp3 | 用最終母帶,不要用壓過又壓的版本 |
| 封面 | 正方形 jpg 或 png | 邊長至少 1000 像素,畫面上會縮到 560 像素顯示 |
| 歌詞 | 純文字 txt | 一行一句,照實際演唱順序寫 |
歌詞檔的規矩:唱幾次就寫幾次
歌詞檔最容易出錯的地方,是副歌。
歌詞本上的副歌通常只寫一次,後面標「重複」。畫面上的歌詞要跟著唱的走,副歌唱三遍,檔案裡就寫三遍。段落標記(Verse、Chorus 這些)可以留著,程式會把它當分組資訊,不會顯示在畫面上。
如果您要做雙語版本——畫面上一行日文、底下一行中文——那就準備兩欄:主行是實際演唱的語言,副行是對照翻譯。
讓 agent 幫您整理成程式吃得下的格式
程式讀的是一份 JSON 檔(一種用括號和引號組織資料的文字格式,程式好讀,人也看得懂)。您不用自己編,交給 agent。
我有一份歌詞文字檔在〔填入:歌詞檔路徑〕,請幫我整理成 lyrics.json,格式如下:

```json
{"lines": [
  {"main": "實際唱出來的那一行", "sub": "對照翻譯,沒有就留空字串", "sec": "段落名稱"}
]}
```

規則:
- 順序就是演唱順序,副歌唱幾次就重複寫幾次。
- `main` 是畫面主行,`sub` 是畫面副行(單語版一律留空字串)。
- `sec` 填段落名稱(Verse 1、Chorus 之類),沒有標記就沿用上一段的。
- 空行與純段落標記行不要變成歌詞行。

整理完存到〔填入:工作資料夾〕/lyrics.json,並回報總共幾行、分成幾個段落。先不要跑其他步驟。對時:讓字幕跟上嘴
這一章是整條流程的核心,也是最容易看出品質差別的地方。
目標是算出每一句歌詞的進點與出點。做法分兩步:先讓電腦聽出「大概」的時間,再用人聲的音量把時間修準。
步驟 1:分離人聲
先把人聲從伴奏裡剝出來。Demucs 是 Meta 出的音源分離工具,跑在自己的電腦上,不上傳雲端。
~/.venvs/lyric/bin/python -m demucs --two-stems=vocals -n htdemucs -o 分離結果資料夾 您的音檔.wav第一次跑會自動下載模型檔。三分多鐘的歌,在我的筆電上大約要一分鐘。
步驟 2:聽出大概的時間
接下來用 faster-whisper(語音轉文字模型的高效版本)聽人聲軌,它會吐出每個字大概唱在第幾秒。同時量人聲軌的音量變化,每 50 毫秒記一個值。
這兩份資料分工很清楚:whisper 負責「哪個字」,音量負責「什麼時候開始有聲音」。
步驟 3:把歌詞和時間對起來
這一步是把您的歌詞檔和 whisper 聽到的字做比對,讓每一句歌詞領到自己的時間。畫面上顯示的字永遠是您的歌詞檔,whisper 只貢獻時間,不貢獻文字。
三個實際踩過的坑都在這一步。
步驟 4:看一眼對時結果
程式會印出每一句的時間與一個「比對率」。比對率低的句子代表 whisper 沒聽清楚,那幾句要自己聽一次。
請依序執行對時流程,腳本在〔填入:scripts 資料夾路徑〕:

1. 用 venv 的 python 跑 `probe_timing.py 〔工作資料夾〕 〔zh 或 ja 或 en〕`。
2. 接著跑 `align_lines.py 〔工作資料夾〕`。
3. 讀 timing.json,把 `cover` 低於 0.5 的句子整理成一張表給我,欄位是:句號、歌詞、進點、出點、比對率。
4. 另外檢查有沒有句子的顯示長度短於 1 秒,或是進點比前一句的出點還早,一併列出來。

先不要渲染影片。我看完這張表再決定要不要手動修時間。渲染:把畫面算出來
對時做完,剩下的就是把畫面算出來。這一步不需要判斷,交給 agent 跑完即可。
一首歌一份 job.json
每一首歌用一份設定檔告訴程式素材在哪、要用哪一套視覺風格。
{
  "series": "lamp",
  "lang": "zh",
  "title": "讚美月光",
  "audio": "音檔的完整路徑.wav",
  "cover": "封面的完整路徑.jpg",
  "work": "工作資料夾路徑",
  "out": "成品要存去哪.mp4"
}
換下一首歌,改的是 title、audio、cover、work、out 這五行。視覺風格那一行維持不變,整張專輯就會長得像一套。
一套風格一份 series.json
視覺參數集中在另一份設定檔,一個系列一組。這是《路燈廣場》夜色版的幾個關鍵欄位:
| 欄位 | 值 | 管什麼 |
|---|---|---|
bg_top / bg_bottom | #0b1633 / #1d2a47 | 背景漸層的上下兩色 |
text | #fff4e0 | 歌詞顏色 |
main_px | 56 | 歌詞字級 |
n_particles | 64 | 背景光點數量 |
vignette | 0.35 | 四角壓暗的程度 |
要調氣氛,改顏色與數量就好。想從零配一套新風格,把您的封面丟給 agent,請它從封面取色再寫一份設定檔,會比自己試快。
為什麼可以切成八段同時算
四分半的歌是八千多幀。一幀一幀慢慢算,單核心要跑很久。
這支程式把畫面切成八段,八個程序同時算,最後接起來。
前提是畫面上每個元素的位置都由「時間」這個變數直接算出,中間沒有一格一格累加的狀態。第 4000 幀不需要知道第 3999 幀發生過什麼,代入時間就能算出光點在哪裡。
接縫因此不會跳。
請幫我渲染這首歌的歌詞影片:

1. 確認〔填入:工作資料夾〕底下有 timing.json 與 rms_db.npy。
2. 用 venv 的 python 跑 `render_full.py 〔job.json 路徑〕 --jobs 8`。
3. 這一步會跑很久(我的機器上單支 11 分鐘到 1.5 小時),中途請不要中斷,跑完回報實際耗時與輸出檔案大小。
4. 如果分段失敗,去 chunks 資料夾讀對應的 log,把錯誤訊息貼給我,先不要自己改腳本。

〔填入:如果您的電腦核心數少於 8,把 --jobs 改成核心數〕驗收:出片之前看三件事
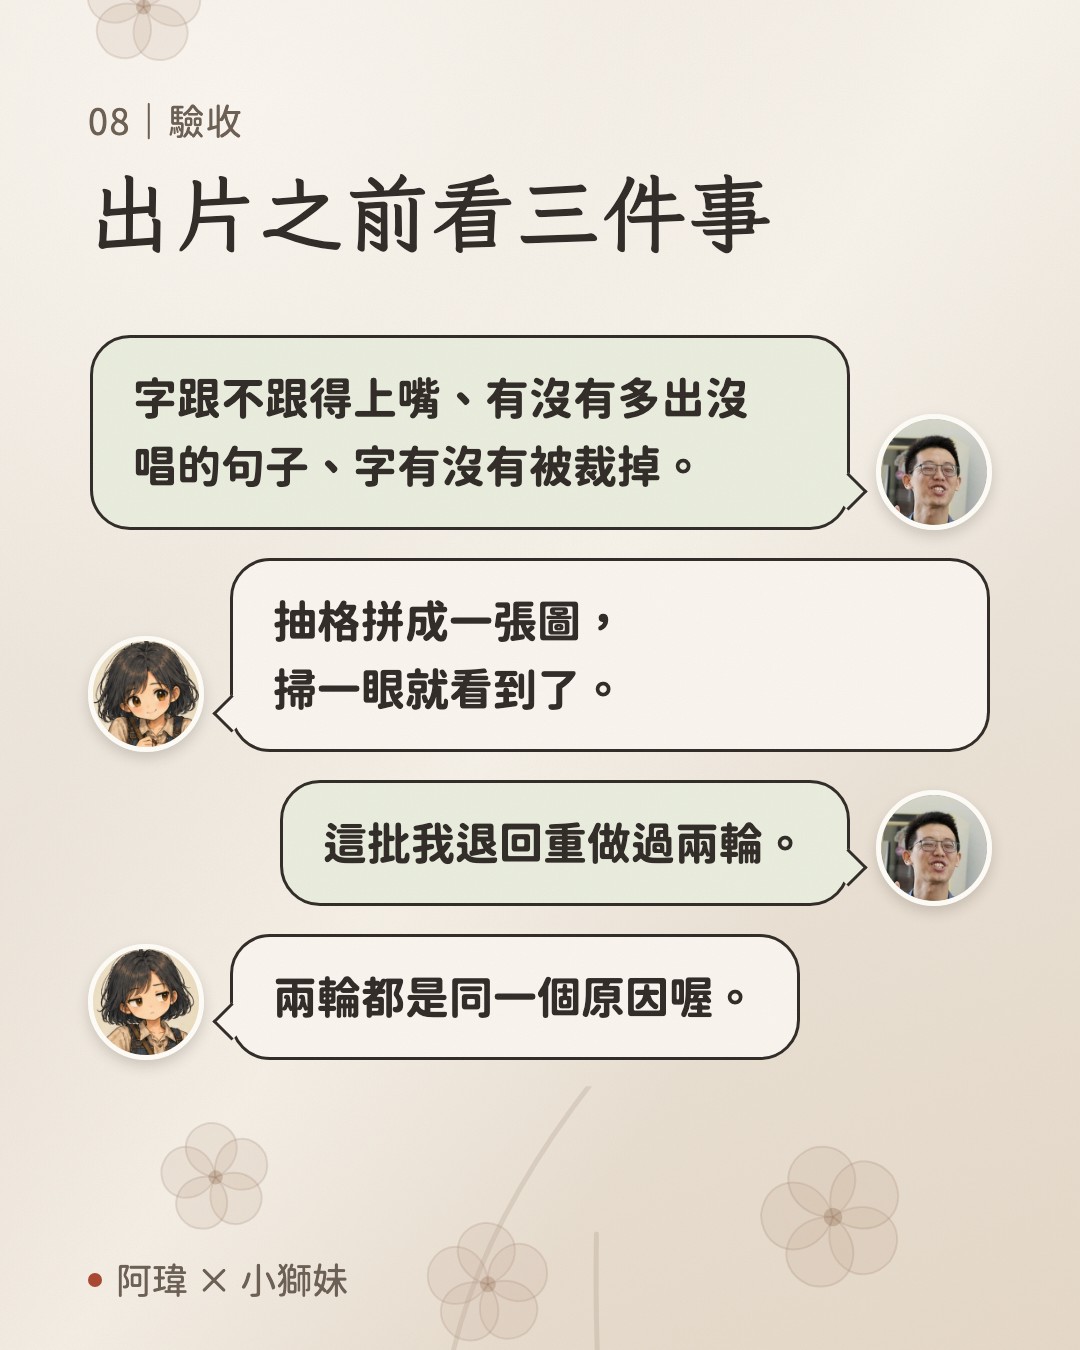
渲染完的檔案不等於做完了。這一批我退回重做過兩輪,問題都出在這三件事上。
一、字有沒有跟上嘴
把影片拉到副歌,聽三句。字幕早半秒或晚半秒,耳朵聽得出來。
有問題就回去改 timing.json 那一句的 t0,只重渲那一段來看,確認好了再整支重跑。
二、有沒有多出沒唱的句子
抽格檢查比從頭看快。用 ffmpeg 每隔幾秒抽一張圖,拼成一張聯絡表(contact sheet,把許多幀縮小排在一起的檢查用圖),一眼掃過去。
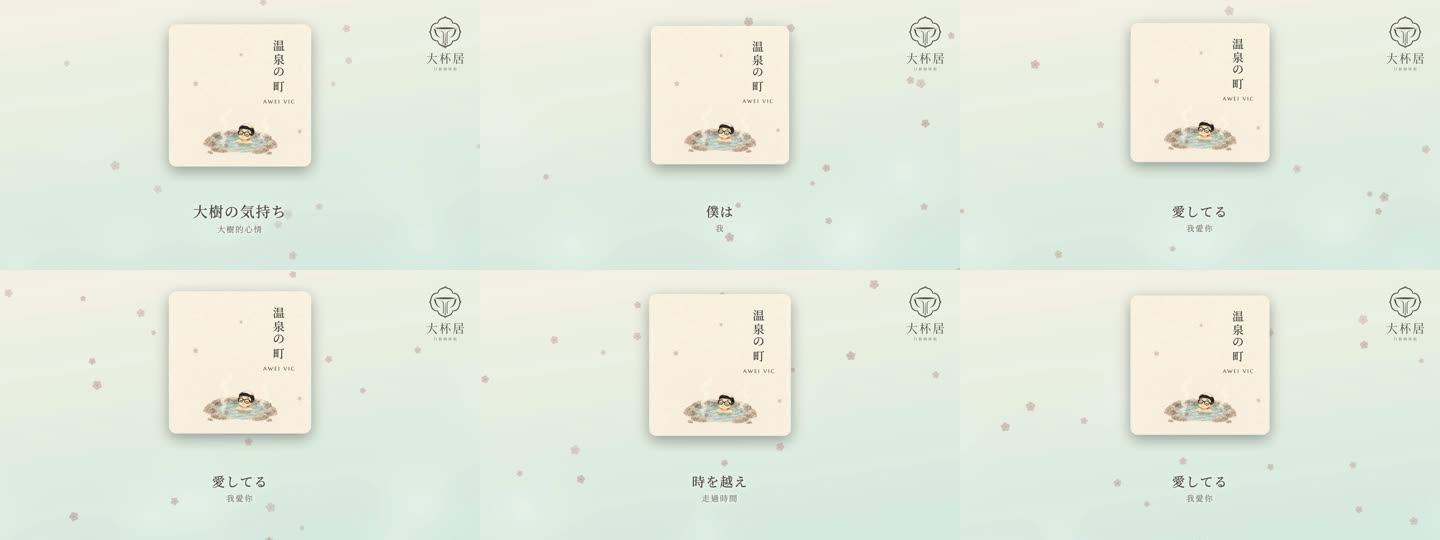
我這批就是靠這張圖抓到三首歌有實際沒唱的段落。
三、字有沒有被裁掉
歌詞面板固定在畫面下方。句子太長時,字會超出面板寬度。
檢查方法是找出最長的那幾句,直接看那幾格。要修有兩條路:把長句在歌詞檔裡拆成兩行,或把 main_px 字級調小兩級。
下面這支是同一套程式的日文版成品,畫面下方同時有日文與中文兩行,可以看看雙語版的排法。
上架:YouTube 的幾個欄位
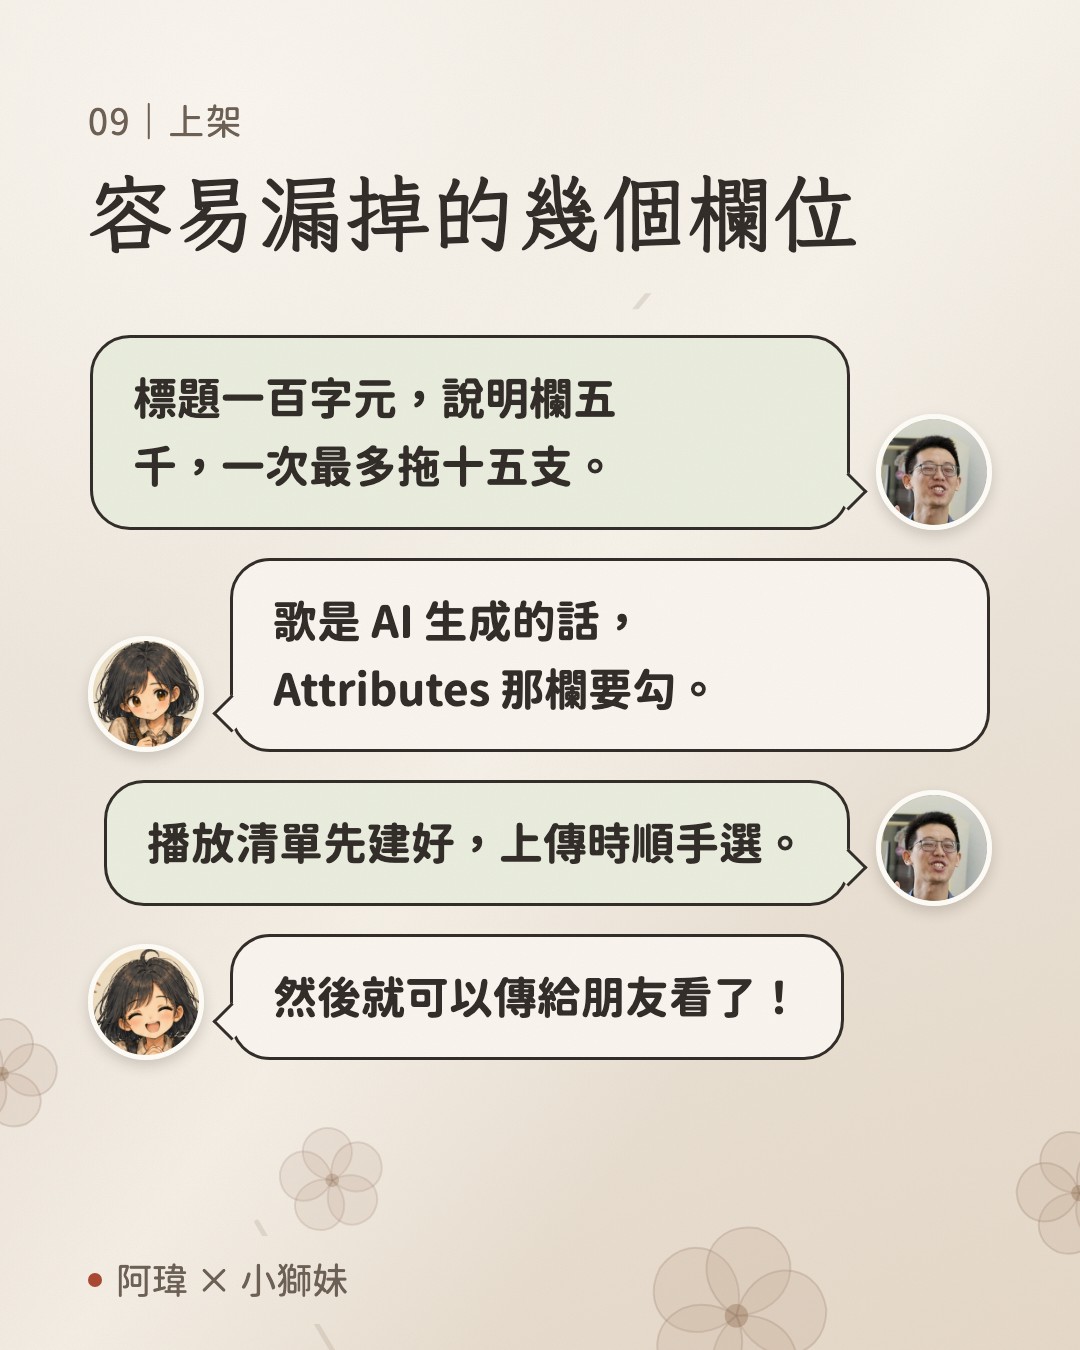
影片做好了,最後一段是上傳。這裡只寫容易漏掉的欄位。
一次可以拖幾支
YouTube Studio 一次最多同時上傳 15 支。帳號沒有完成驗證的話,單支影片長度上限是 15 分鐘;完成驗證之後是 256 GB 或 12 小時,以先到的為準。(2026 年 9 月查證)
標題上限 100 個字元,說明欄上限 5000 個字元。整首歌詞貼進說明欄通常放得下。
AI 生成內容要不要揭露
如果您的音樂是 AI 生成的,這一欄需要處理。
YouTube 的規定是:內容看起來逼真、可能被誤認為真實時要揭露。官方明文把 AI 生成音樂列在需要揭露的項目裡。操作位置在上傳流程的「顯示更多」裡,Attributes 區塊的「AI use」欄位,選「是」。
揭露之後,逼真類的內容會在播放器上顯示標籤,其他類型則顯示在展開後的說明欄。
播放清單先建好
上傳流程的 Details 那一步就能選播放清單。一張專輯建一個清單,上傳時順手選,比事後一支一支加快。
被誤判成別人的音樂怎麼辦
自己創作的音樂被 Content ID(YouTube 的版權比對系統)主張的情況會發生。
處理方式是先提出爭議(Dispute),聲明您擁有全部權利。對方三十天內拒絕的話,可以再提出申訴(Appeal),對方要在七天內回覆。
如果該筆主張已經導致影片被封鎖,可以直接走 Escalate to Appeal。
Q&A
門檻
Q:我完全不會寫程式,這篇的東西我做得起來嗎?
做得起來,前提是您願意在終端機裡貼指令。文章裡的每一段程式碼都是現成的,您的工作是把它交給 agent,然後判斷結果對不對。真正需要您判斷的只有三件事:歌詞檔對不對、字有沒有跟上嘴、顏色喜不喜歡。
Q:非得用 Mac 不可嗎?
不用。四支腳本裡唯一跟作業系統有關的是找 Chrome 執行檔的那一段,文章附的版本已經改成會自己找 macOS、Windows 與 Linux 的常見位置,也可以用環境變數指定。不過我只在 macOS 上實測過,Windows 上如果卡住,把錯誤訊息貼給 agent 通常能解。
Q:我的電腦很舊,跑得動嗎?
我這批是在 2019 年的筆電上跑的,Intel i9、16 執行緒、沒有用到顯示卡算圖。舊機器的差別在慢,不在做不出來。
費用與時間
Q:這樣做要花多少錢?
渲染流程本身不花錢,全部在自己的電腦上算。要付費的只有 Claude Code 的帳號(Pro 以上方案)。如果您的音樂是用生成服務做的,那筆費用另計。
Q:第一次做要多久?
環境裝起來大約半小時。第一首歌從素材到成片,含對時檢查與重渲,抓一個下午。第二首之後,改五行設定檔,剩下的是等渲染。
Q:整張專輯要怎麼排?
寫一份清單,讓 agent 一支一支照順序跑,做完的記進一個檔案,中途停掉也能接著跑。我這批十一支就是這樣掛著過夜跑完的。
歌詞與對時
Q:副歌重複要怎麼寫?
唱幾遍就在歌詞檔裡寫幾遍。這是最常見的出錯點。
Q:字幕可以逐字亮起來嗎?
文章附的這一版是整句淡入淡出。逐字亮起需要每個字的時間,資料其實已經有了(whisper 給的是逐字時間戳),改的是渲染那一段的顯示邏輯。這篇沒有做到那裡。
Q:純演奏的段落,畫面上放什麼?
程式會在超過六秒的空檔自動浮出曲名,空檔結束再淡掉。這是 lyric_video.py 裡那段「長空檔顯示曲名」的邏輯。
版權與揭露
Q:用別人的歌做歌詞影片可以嗎?
這條流程是給自己有權利的歌用的。別人的歌牽涉重製與公開傳輸的授權,不在這篇的範圍。
Q:歌是 AI 生成的,上傳時要揭露嗎?
要。YouTube 官方把 AI 生成音樂列在需要揭露的項目裡,位置在上傳流程的 Attributes → AI use。
最後
這些 Demo 從二號路燈和小杯居時期就都在了,細數時日,十來年了。
(大二那年開始寫歌,哇,2013 還是 14 年的事情了。)
這篇就是一個音樂夢的小小起點,我把四支腳本和一份設定檔整理出來,想著如果有人也要做,照著跑就好,不必再摸一次我摸過的路。
雖然是全 AI 校潤和編曲,概念上已經是「虛擬歌手 葉阿瑋」了,但聽著自己的「創作動機」透過科技的輔助具象化,仍然滿心歡喜。
After AI 的時代,我無情的把重複且機械化的那部分,全部外包。
我願悉心且珍重的呵護,那熱愛音樂的,粗糙而拙劣的初心。
阿瑋 記於 2026 年 9 月 23 日
這條流程的分離與對時部分,沿用了我做和弦譜時寫的腳本;對時演算法的選擇,參考了生物資訊學的序列比對方法。文中的實測數字都來自我自己的機器,您的環境跑出來會不一樣。
參考來源(12 筆,2026-09-23 查證)
- Claude Code — Advanced setup
- Homebrew Formulae: ffmpeg
- Download FFmpeg
- Demucs(adefossez 維護分支)
- SYSTRAN/faster-whisper
- PyPI: numpy
- YouTube — Disclosing use of altered or synthetic content
- YouTube — Understanding "How this content was made" disclosures
- YouTube — Disclose gen AI usage for music content
- YouTube — Upload YouTube videos
- YouTube — Upload videos longer than 15 minutes
- YouTube — Dispute a copyright claim